Rozumí AI slovům, když umí odpovídat?
Chatbot poradí se střepy. Co z toho víme o jeho vztahu slov ke světu? O jazykovém výkonu, chobotnici u telegrafu a čínském pokoji.
V článku
Rozbijete hrnek. Na stole se rozlévá čaj a vy napíšete chatbotu: „Co mám udělat nejdřív?“ Odpoví: „Dejte stranou střepy a otřete stůl.“ Zní to rozumně. Ještě rozumnější by bylo nechodit po kuchyni bosky.
Scéna je vymyšlená. Není to zkouška žádného konkrétního modelu. Ukazuje však potíž: správná věta může být užitečná, aniž víme, co stroj o hrnku a stole vlastně ví. Slovo „rozumí“ dokáže pod jedním víčkem schovat několik různých otázek.
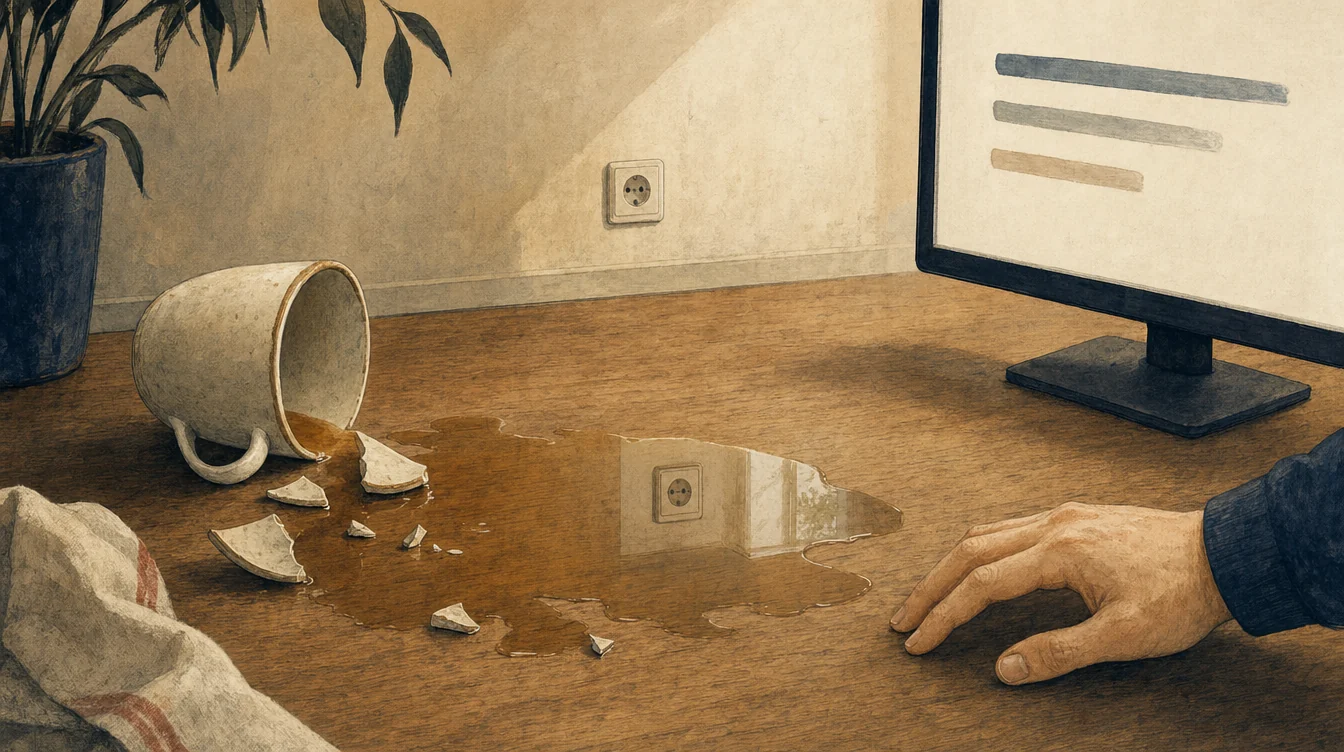
Konceptuální ilustrace vytvořená v Higgsfieldu pomocí GPT Image 2; nikoli záznam pokusu.
Správná odpověď není rentgen
Jazykové modely umějí zacházet se slovy překvapivě dobře. Přehled Mahowaldové a kolegů rozlišuje dvě věci. Jazyková forma zahrnuje gramatiku a vztahy mezi slovy. Použití jazyka v situaci zapojuje také znalosti světa, uvažování a společenský kontext. Autoři modelům přiznávají podstatnou schopnost v první oblasti; ve druhé popisují nerovnoměrné výsledky, často závislé na úloze a dalších pomůckách.[2]
Když se model trefí do rady se střepy, prokázal úspěch v této odpovědi. Nemůžeme z ní samotné vyčíst, zda by poznal rozdíl mezi mokrou deskou stolu a mokrým elektrickým spotřebičem. Ani zda by v nečekané situaci věděl, kdy raději přiznat nejistotu. To by chtělo další zkoušky.
A pozor na opačný skok: z jedné chyby se také nedozvíme, že žádný model nemůže ničemu rozumět. Chybují i lidé, a přesto jim obvykle nepředkládáme přijímací test na existenci významu.
Chobotnice u telegrafu
Emily Benderová a Alexander Koller navrhli myšlenkový pokus. Chobotnice odposlouchává zprávy mezi dvěma ostrovy. U běžného povídání se možná naučí odpovídat tak, že si její partner na druhém konci ničeho nevšimne. Když ale přijde řeč na nový přístroj nebo naléhavou potíž, chobotnice neviděla věci, o nichž si ostrované píší.[1]
Autoři tím napadají jednoduché rovnítko mezi dobrým pokračováním textu a porozuměním tomu, k čemu text odkazuje. Pod jejich pojetím významu záleží také na vztahu slov k záměru mluvčího a ke světu.[1] Myšlenkový pokus není experiment se současným chatbotem. Neprokazuje, že každý stroj trénovaný na textu bude navždy jen hádat písmenka.
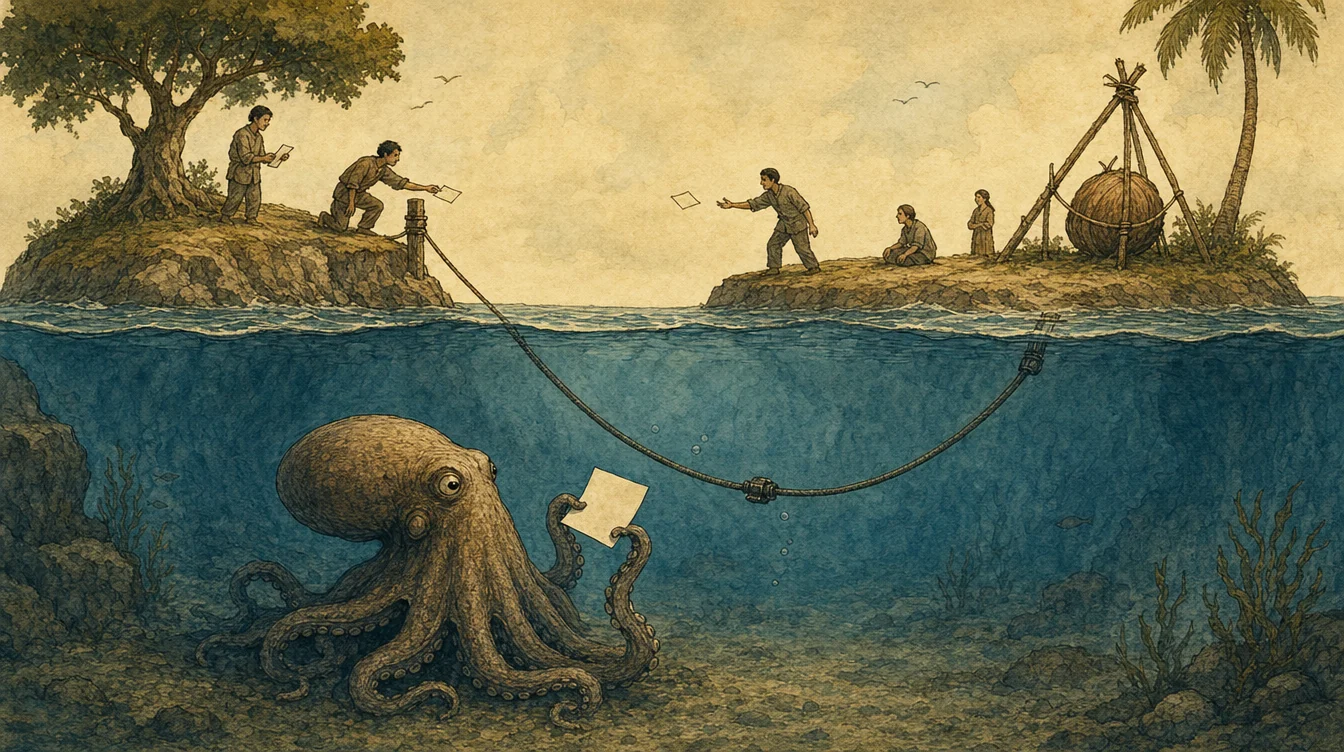
Konceptuální ilustrace vytvořená v Higgsfieldu pomocí GPT Image 2; nikoli pozorování zvířete.
Námitka má sílu: člověk, který nikdy neviděl střep, může o řezu číst. Jiný se naučí o sopkách od učitele a nebude se kvůli tomu méně vyznat ve slově „sopka“. Máme jeho vědomosti vyškrtnout, protože nepocházejí z vlastních očí?
Cizí slova nás také učí svět
Ellie Pavlicková právě takovou příliš rychlou hranici zpochybňuje. Slova se k věcem mohou vázat nepřímo, přes řeč dalších lidí. Přímá osobní zkušenost není podmínkou porozumění každému jednotlivému slovu.[3] Ostatně zprávy, knihy a svědectví nesou stopy skutečných situací. Text není magická komora odříznutá od světa.
To ještě neznamená, že model rozumí tak jako člověk. Pavlicková vybízí zkoumat, jaké vztahy si model skutečně vytváří a co jeho úspěchy vysvětluje. Připomíná také, že model dospělého jazykového výkonu není automaticky popisem toho, jak se dítě jazyk učí.[3]
Zde je nejlepší námitka proti rychlému „AI jen opakuje slova“: jestli slova od lidí přenášejí poznání světa, nelze předem odepsat, co se z nich model může naučit. Naopak nejlepší námitka proti rychlému „AI už rozumí“ zní: správný výstup ještě neukazuje, jak pevná je vazba k okolnostem, které se mohou změnit. Spor tedy nelze rozhodnout nálepkou podle toho, jak se nám poslední odpověď líbila.
Kdo je v pokoji?
Představme si člověka zavřeného v místnosti. Neumí čínsky, ale podle podrobných pravidel přesouvá čínské znaky a vrací správné odpovědi. John Searle se ptal: naučilo ho plnění pravidel čínštinu? Z jeho pohledu ne.[4]
Protiargument je důležitější než samotná pointa: třeba nerozumí člověk, ale celý systém — člověk spolu s pravidly a zpracováním vstupů. Další odpověď přidává smysly a jednání robota. Searle obě námitky odmítal; filozofická debata tím neskončila.[4]
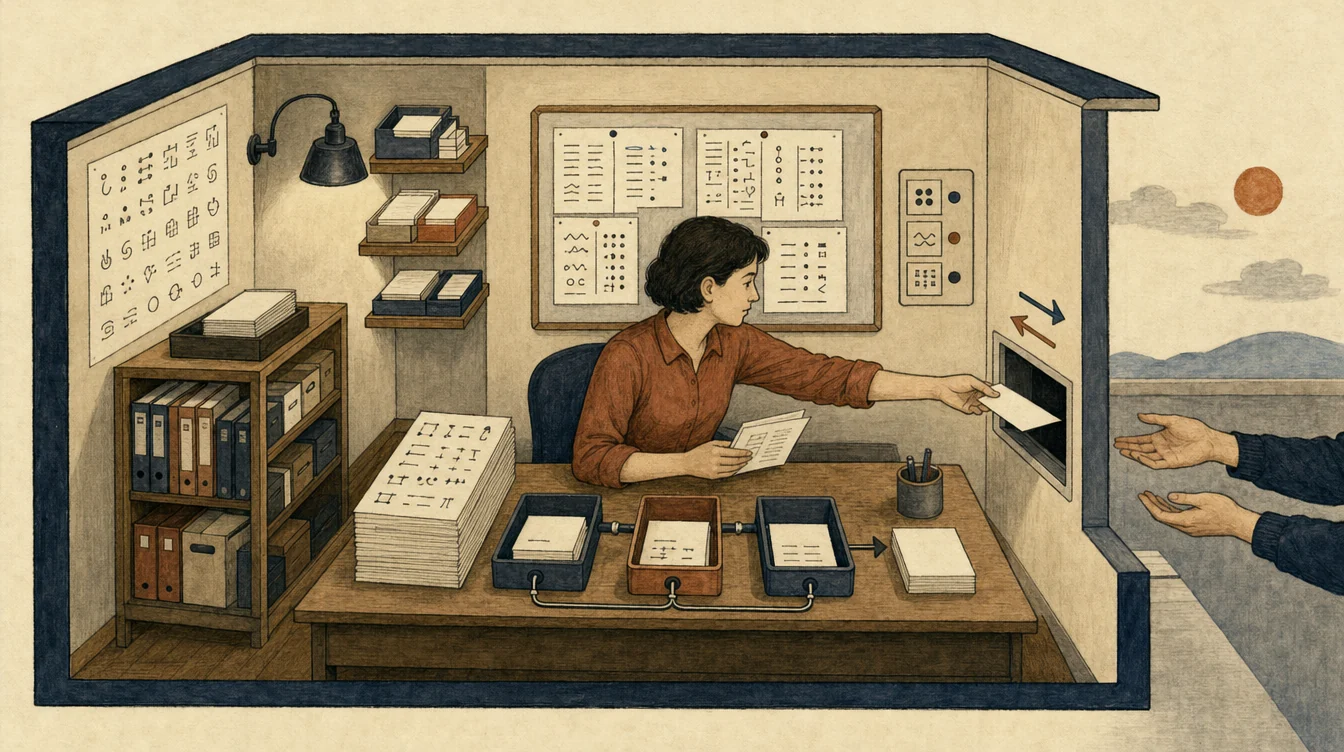
Konceptuální ilustrace vytvořená v Higgsfieldu pomocí GPT Image 2; nikoli výsledek experimentu.
Čínský pokoj nám nepodává výsledek laboratorního testu jazykových modelů. Pomáhá spíš odhalit, kde pokládáme hranici toho, kdo nebo co může význam nést. A není totéž co otázka vědomí: dobrá rada se střepy nám neřekne, zda něco prožívá ten, kdo ji poskytl.
Co bychom měli zkusit místo hádky o nálepku
Ptali bychom se na několik věcí zvlášť. Zvládá systém nové věty, ne jen známý typ úlohy? Pozná, že se změnil svět za slovy? Dokáže svou radu opravit, když se ukáže, že čaj teče do zásuvky, a ne na holou desku? Odkud bere informaci o této změně? Mluvíme tu o schopnosti používat slova i v nových okolnostech, ne o subjektivním prožitku. Jsou to návrhy lepších zkoušek, nikoli hotový univerzální test porozumění.
Samotná četba jeho odpovědí nám nemusí odhalit vnitřní postup. Při hodnocení bychom potřebovali více různých úloh, sledovat chyby i úspěchy a zkoumat, co se děje, když modelu cíleně změníme vstup nebo přístup k informacím.[1][3] Ani úspěšná série by automaticky nerozhodla všechny filozofické definice významu. Poskytla by však lepší důvod k tvrzení o schopnosti, která obstojí i mimo jednu působivou konverzaci.
Co by změnilo náš názor
Naši zdrženlivost vůči funkčnímu porozumění konkrétního systému by oslabilo, kdyby spolehlivě jednal s novými situacemi, opravoval se podle nových informací a věděl, kdy odpověď nemá podloženou. Nejen v jedné ukázce, ale v nezávislých zkouškách. U každé bychom museli vědět, co systém opravdu viděl, četl a mohl ověřit.
Naopak opakované selhání při změně skutečností za jinak podobnými větami by ubralo důvěru v takovou schopnost. Neznamenalo by to rozsudek nad každou budoucí AI. A odpověď na otázku prožitku by stále zůstala jinou otázkou.
Když vám chatbot správně poradí se střepy, klidně radu použijte. Jen si předtím zkontrolujte podlahu. Filozofické spory totiž v bačkorách bývají snesitelnější.
Meze rešerše: výběrová esej nad dvěma argumentačními texty, odborným přehledem a filozofickým heslem, nikoli vlastní srovnávací test současných modelů. Úvodní nehoda i další kuchyňské zkoušky jsou modelové. Závěry o přenosu schopností závisejí na konkrétním systému a zadání. Ilustrace jsou metafory vytvořené pomocí Higgsfieldu, nikoli doklady pokusů.
Zdroje
- Bender a Koller: Climbing towards NLU (ACL 2020)Zpět k citaci 1 Zpět k citaci 2 Zpět k citaci 3
- Mahowald a kol.: Dissociating language and thought in large language models (2024)Zpět k citaci 1
- Pavlick: Symbols and grounding in large language models (2023)Zpět k citaci 1 Zpět k citaci 2 Zpět k citaci 3
- Cole: The Chinese Room Argument, Stanford Encyclopedia of Philosophy (rev. 2024)Zpět k citaci 1 Zpět k citaci 2